深度剖析,Spark HBase 处理大数据的能力究竟如何?
在当今数字化时代,数据量呈爆炸式增长,如何高效处理大数据成为了众多企业和开发者关注的焦点,Spark 和 HBase 作为大数据处理领域的重要技术,它们能否胜任处理海量数据的重任呢?
Spark 是一种快速、通用的大数据处理框架,具有出色的计算能力和灵活性,HBase 则是一个分布式、面向列的数据库,适用于大规模数据的实时读写。
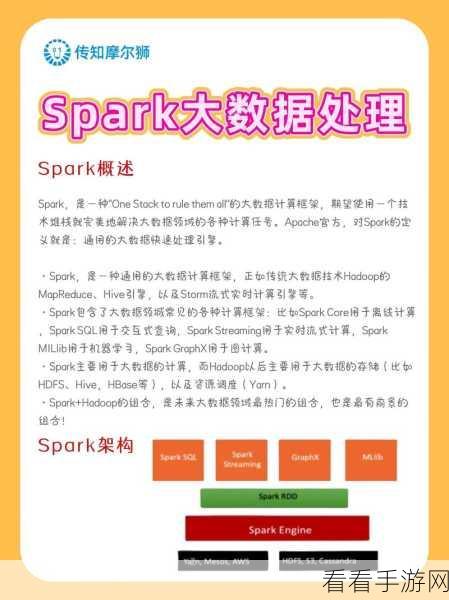
要探究 Spark HBase 能否处理大数据,我们需要从多个方面进行分析,从性能角度来看,Spark 凭借其强大的内存计算能力,可以在短时间内完成复杂的数据处理任务,而 HBase 则以其出色的扩展性和高并发读写能力,能够应对海量数据的存储和访问需求。
在数据处理的多样性方面,Spark 支持多种数据处理方式,如批处理、流处理和机器学习等,HBase 则主要用于结构化数据的存储和查询。
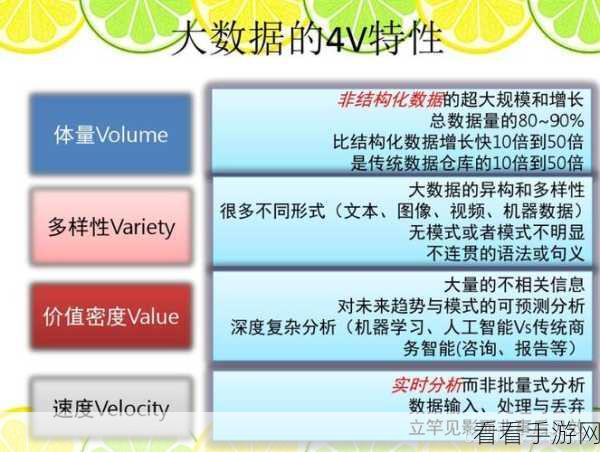
从数据安全性和一致性的角度考虑,Spark 和 HBase 都提供了一定的保障机制,但在具体应用中需要根据实际情况进行合理的配置和优化。
实际应用中的案例也能为我们提供有力的参考,许多大型企业在处理大数据时,成功地将 Spark 和 HBase 结合起来,实现了高效的数据处理和分析。
Spark HBase 在处理大数据方面具有很大的潜力和优势,但要充分发挥它们的作用,还需要根据具体的业务需求和场景进行合理的架构设计和优化。
文章参考来源:大数据技术相关研究资料及实际应用案例分析。
