破解 Apache Kafka 与 Spark 集成之谜
Apache Kafka 与 Spark 的集成一直是众多开发者关注的焦点,它们的集成到底难不难呢?
要深入探讨这个问题,我们先来了解一下 Apache Kafka 和 Spark 各自的特点,Apache Kafka 是一个分布式的消息队列系统,以其高吞吐量、低延迟和可扩展性而闻名,而 Spark 则是一个强大的大数据处理框架,能够快速高效地处理大规模数据。
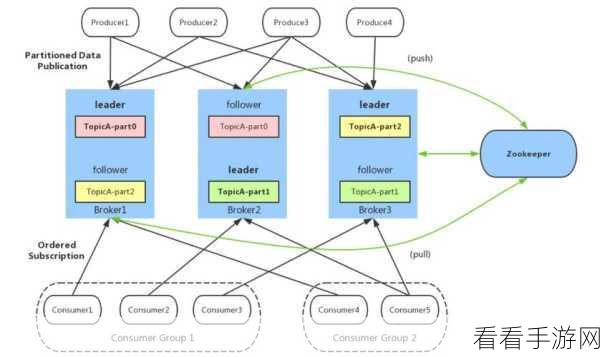
两者集成的难点主要在于数据的传输和处理方式的匹配,Kafka 中的数据是以流的形式存在的,而 Spark 在处理数据时有着自己独特的方式和要求,这就需要在集成过程中,进行一系列的配置和优化,以确保数据能够准确、高效地在两者之间传递和处理。
在集成过程中,数据格式的转换也是一个关键环节,不同的数据格式可能会导致数据的解析错误或者处理效率低下,需要选择合适的数据格式,并进行相应的转换处理。
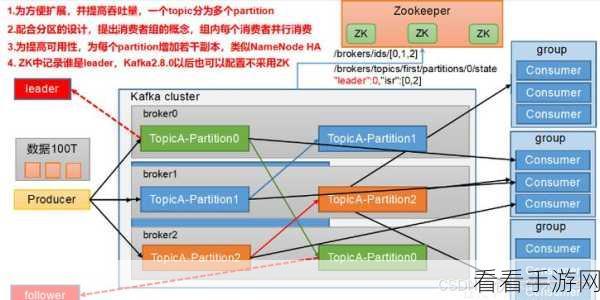
系统的性能调优也是不可忽视的,包括内存的分配、线程的管理以及网络带宽的利用等方面,都需要根据实际的业务需求和系统环境进行精细的调整。
为了成功实现 Apache Kafka 与 Spark 的集成,我们可以采取以下步骤:
第一步,明确业务需求和数据处理目标,这将有助于确定集成的方式和重点关注的方面。
第二步,进行详细的系统配置,包括 Kafka 的主题设置、分区策略,以及 Spark 的任务参数、资源分配等。
第三步,进行充分的测试和验证,通过实际的数据处理和性能评估,确保集成后的系统能够稳定运行,并达到预期的效果。
Apache Kafka 与 Spark 的集成虽然存在一定的挑战,但只要我们深入理解两者的工作原理,合理进行配置和优化,就能够成功实现高效的数据处理和集成。
文章参考来源:相关技术文档及行业实践经验。
