Python 爬虫与反爬虫,掌握技巧与应对策略
Python 爬虫与反爬虫技术,一直是编程领域备受关注的焦点,在当今数字化时代,数据的获取和保护至关重要,了解和掌握 Python 爬虫与反爬虫的技巧,不仅对于开发者来说是一项重要技能,也对于维护网络数据的正常秩序有着深远意义。
爬虫技术能够帮助我们快速获取大量有价值的数据,为数据分析、机器学习等领域提供基础支持,过度的爬虫行为可能会对网站造成负担,甚至违反法律法规,反爬虫技术应运而生,旨在保护网站的正常运行和数据安全。
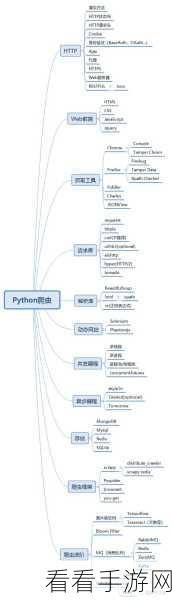
要掌握 Python 爬虫技术,需要熟悉一些基本的库和工具,如 Requests、BeautifulSoup 等,通过发送 HTTP 请求获取网页内容,并对其进行解析和提取所需数据,还需要注意处理反爬虫机制,如设置合理的请求头、控制请求频率等。
反爬虫技术则包括多种手段,比如验证码识别、IP 封禁、访问频率限制等,开发者需要了解这些反爬虫机制的原理,并通过相应的技术手段来突破限制,使用代理 IP 来规避 IP 封禁,或者通过模拟人类行为来降低被识别为爬虫的风险。
在实际应用中,还需要遵循法律法规和道德规范,不得用于非法获取数据或侵犯他人权益,合理使用爬虫技术,能够为我们的工作和研究带来便利;而有效的反爬虫措施,则能够保障网站的稳定和数据的安全。
Python 爬虫与反爬虫技术是一个相互博弈的领域,只有不断学习和探索,才能在合法合规的前提下,更好地运用这一技术,为我们的生活和工作创造更多价值。
参考来源:相关技术论坛及专业书籍。
