Hadoop 与 Spark 常见难题大揭秘
在当今的大数据处理领域,Hadoop 和 Spark 无疑是最为重要的技术框架,在实际应用中,它们也会面临一系列的常见问题,就让我们深入探讨一下这些问题。
Hadoop 常见问题之一是其扩展性的挑战,当数据量不断增长,Hadoop 集群的扩展可能会变得复杂且困难,增加新的节点时,需要考虑数据的重新分布和平衡,否则可能会导致性能下降。
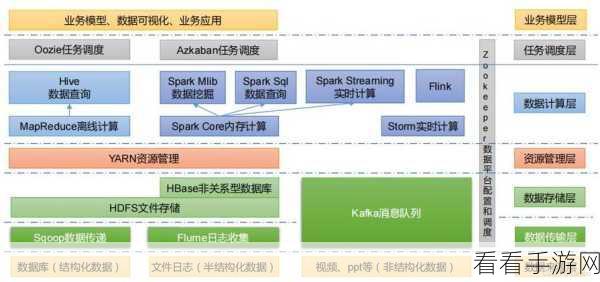
Spark 常见的问题则在于内存管理,由于 Spark 对内存的依赖较高,如果任务分配的内存不合理,很容易出现内存溢出的错误,从而影响整个计算任务的执行。
对于 Hadoop 数据的一致性也是一个关键问题,在分布式环境中,多个节点同时操作数据,如何确保数据的一致性是至关重要的,否则,可能会导致数据的错误和不一致。
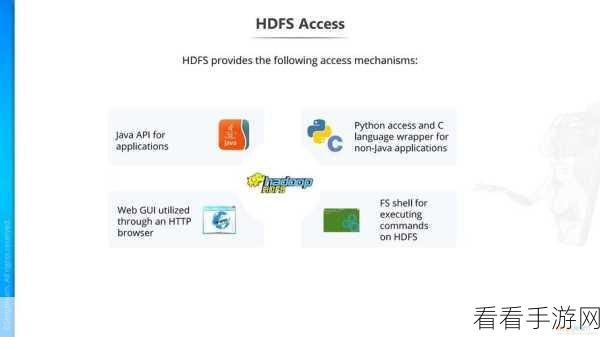
而 Spark 的性能优化也是许多开发者头疼的问题,如何根据具体的业务场景和数据特点,合理地调整参数,以达到最佳的性能,需要深入的理解和实践经验。
要解决 Hadoop 的扩展性问题,需要提前做好规划和设计,合理划分数据块,优化节点之间的通信。
针对 Spark 的内存管理问题,开发者需要精确地评估任务所需的内存,并通过设置合适的参数来控制内存的使用。
在处理 Hadoop 数据一致性问题时,可以采用合适的一致性算法和机制,加强数据的校验和监控。
对于 Spark 的性能优化,除了调整参数外,还可以考虑使用更高效的数据结构和算法,以及对代码进行优化。
要熟练掌握 Hadoop 和 Spark ,并有效地解决它们常见的问题,需要不断的学习和实践,积累丰富的经验,只有这样,才能在大数据处理的道路上越走越稳,取得更好的成果。
参考来源:相关技术论坛及官方文档。
