深入探索大数据 Spark Hadoop 生态系统的奥秘
大数据领域中,Spark 和 Hadoop 构建的生态系统具有举足轻重的地位。
Spark 和 Hadoop 生态系统的出现,是为了应对海量数据处理和分析的需求,它们提供了一系列强大的工具和技术,使得数据的存储、计算和分析变得更加高效和便捷。
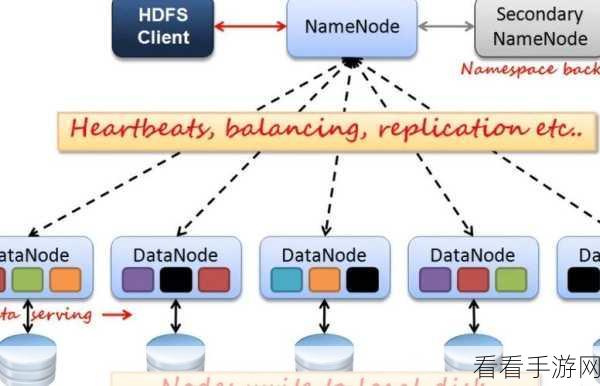
在数据存储方面,Hadoop 的分布式文件系统 HDFS 能够容纳海量的数据,具有高可靠性和容错性,而 Spark 则擅长数据处理和计算,其基于内存的计算模型大大提高了数据处理的速度。
对于数据分析,Spark 提供了丰富的 API 和库,支持多种数据分析任务,如数据清洗、特征工程、机器学习等,Hadoop 的 MapReduce 框架在大规模数据的并行处理上也发挥着重要作用。
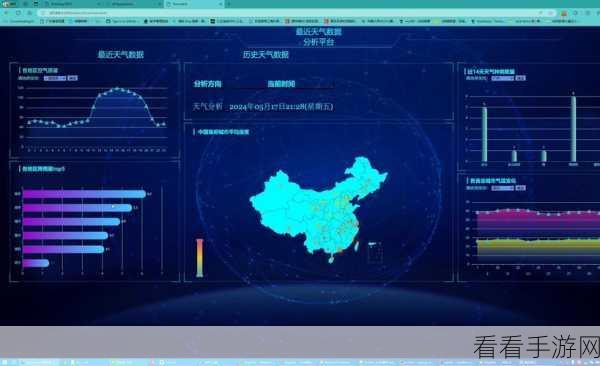
在实际应用中,企业可以根据自身的需求和数据特点,灵活选择和组合 Spark 和 Hadoop 的组件,以构建适合自己的大数据处理架构,对于实时性要求较高的数据分析任务,可以更多地依赖 Spark 的实时处理能力;而对于大规模数据的批量处理,则可以充分利用 Hadoop 的优势。
要充分发挥 Spark 和 Hadoop 生态系统的作用,还需要掌握相关的技术和优化技巧,合理配置资源、优化数据存储和计算流程等。
深入了解和掌握 Spark 和 Hadoop 生态系统,对于处理和分析海量数据,挖掘数据价值具有重要意义。
参考来源:大数据相关技术文献及行业研究报告。
