深入探究,Spark 函数在分布式计算中的支持状况
Spark 函数作为大数据处理领域的关键组成部分,其在分布式计算中的支持情况备受关注。
Spark 函数具备强大的计算能力和高效的数据处理优势,在大规模数据处理场景下,能否充分发挥其性能,很大程度上取决于对分布式计算的支持程度。
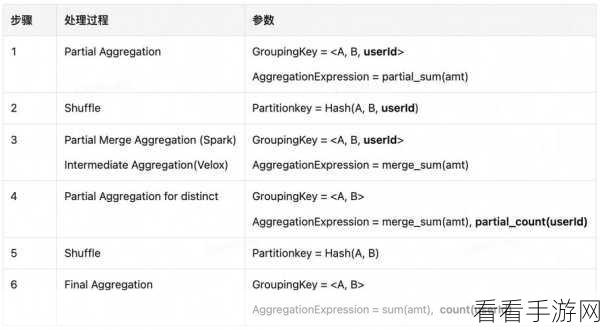
要深入理解 Spark 函数对分布式计算的支持,需先从其核心架构和设计理念入手,Spark 采用了基于内存的计算模型,通过将数据尽可能地缓存在内存中,减少了磁盘 I/O 操作,从而显著提高了计算效率,而这种内存计算的模式,对于分布式计算环境中的数据分发和任务调度提出了更高的要求。
Spark 函数在分布式计算中的支持还体现在其丰富的编程接口和 API 上,开发者可以使用多种编程语言,如 Java、Scala、Python 等,来编写 Spark 应用程序,这些编程语言提供了简洁而强大的语法,使得开发者能够轻松地表达复杂的计算逻辑,并将其转化为高效的分布式计算任务。
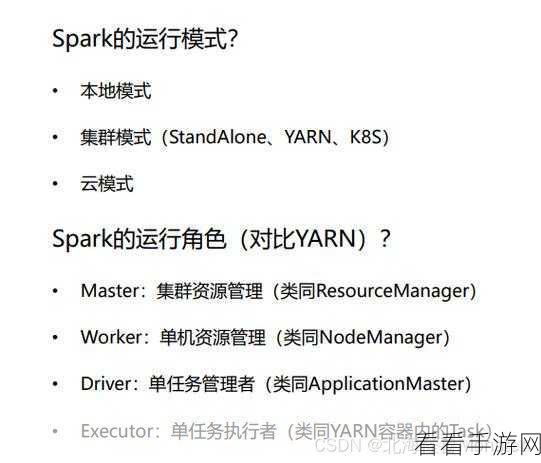
Spark 函数的容错机制也是其支持分布式计算的重要保障,在分布式环境中,节点故障和网络延迟等问题不可避免,Spark 通过数据备份、任务重试等机制,确保在出现故障时,计算任务能够继续执行,而不会导致数据丢失或计算结果错误。
Spark 函数在分布式计算方面提供了强大的支持,但要充分发挥其优势,还需要开发者深入了解其原理和特性,并结合实际应用场景进行优化和调整。
参考来源:相关技术文档及行业研究报告。
仅供参考,您可以根据实际需求进行修改和调整。
