Spring Kafka 处理海量数据的能力大揭秘
在当今数字化时代,数据处理成为了众多应用场景中的关键环节,而 Spring Kafka 作为一种常用的技术框架,其处理大量数据的能力备受关注,Spring Kafka 到底能否胜任处理海量数据的重任呢?
Spring Kafka 具有一系列特性,使其在应对大规模数据处理时具备一定的优势,它拥有高效的消息传递机制,能够确保数据的快速传输和处理,其良好的扩展性使得在数据量不断增长的情况下,能够轻松地通过增加资源来提升处理能力,Spring Kafka 提供了丰富的配置选项,可以根据具体的业务需求进行优化调整,从而更好地适应不同规模的数据处理任务。
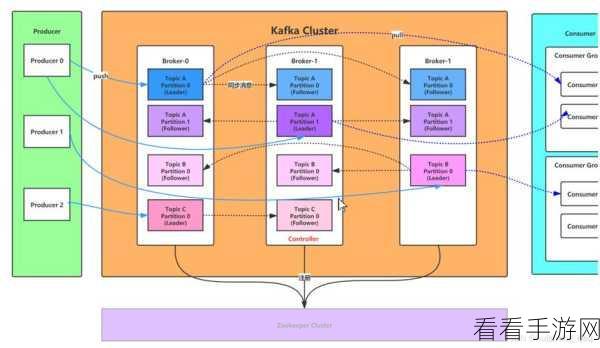
要实现 Spring Kafka 对大量数据的有效处理,也需要注意一些关键因素,合理的分区策略是至关重要的,通过恰当的分区设置,可以将数据均匀分布到不同的节点上,避免出现数据倾斜和处理瓶颈,对消费者和生产者的性能优化也不能忽视,调整相关参数,如缓冲区大小、批量发送大小等,可以显著提高数据处理的效率。
监控和错误处理也是保障 Spring Kafka 稳定处理大量数据的重要环节,实时监控系统的各项指标,如消息积压、延迟等,能够及时发现潜在问题并采取相应措施,在出现错误时,要有完善的错误处理机制,确保数据的完整性和处理的连续性。
Spring Kafka 在处理大量数据方面具有很大的潜力,但需要在实际应用中结合具体情况进行合理的配置和优化,同时注重监控和错误处理,才能充分发挥其优势,满足业务需求。
文章参考来源:相关技术文档及实践经验总结。
