Hive 索引如何在数据分区大放异彩
Hive 索引在数据分区领域发挥着至关重要的作用,它不仅能够显著提升数据查询的效率,还能优化数据存储和管理。
Hive 索引的应用场景丰富多样,在大规模数据处理中,当面临海量数据需要快速检索和分析时,Hive 索引能够精准定位所需数据,减少不必要的数据扫描,从而大幅缩短查询时间。
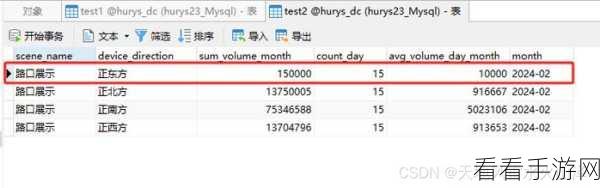
要深入理解 Hive 索引在数据分区中的应用,需要掌握其工作原理,Hive 索引通过建立特定的数据结构,对数据进行分类和组织,使得在查询时能够快速定位到相关数据所在的分区,进而提高查询的准确性和速度。
实际应用中,合理设置 Hive 索引至关重要,需要根据数据的特点、查询的模式以及系统的资源状况来进行精心规划,对于频繁查询的字段,创建合适的索引能够带来显著的性能提升;而对于数据更新频繁的情况,则需要谨慎考虑索引的创建,以免带来过多的维护成本。
在数据分区中,Hive 索引还能够与其他技术手段相结合,进一步提升系统的整体性能,与数据压缩技术配合使用,可以在节省存储空间的同时,不影响查询效率。
Hive 索引在数据分区中的应用是一个复杂但极具价值的领域,深入研究和掌握其应用技巧,对于提升大数据处理和分析的能力具有重要意义。
文章参考来源:相关技术文档及行业研究报告。
