深入探究,Spark GroupBy 的实现秘籍
Spark 的 GroupBy 操作在大数据处理中具有关键作用,想要深入理解并熟练运用它,需要掌握一系列的知识和技巧。
GroupBy 操作是 Spark 框架中用于数据分组和聚合的重要手段,它能够按照指定的列对数据进行分组,然后对每个分组执行相应的聚合计算,比如求和、平均值、计数等,理解其工作原理对于优化数据处理流程和提高计算效率至关重要。
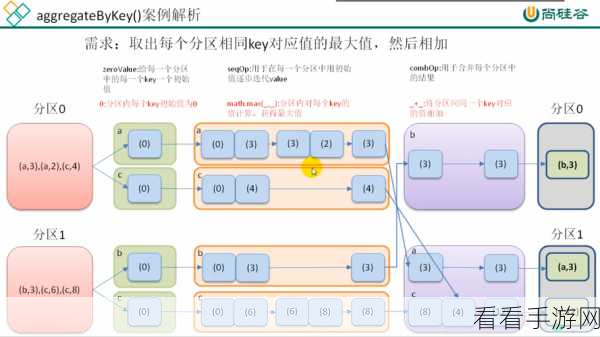
要实现 Spark 的 GroupBy 操作,首先需要准备好数据,确保数据的格式正确,并且包含了用于分组和聚合计算的相关列,使用 Spark 的 DataFrame 或 RDD 接口来执行 GroupBy 操作,通过指定分组的列名,就可以将数据进行分组。
在执行聚合计算时,可以根据具体需求选择不同的聚合函数,使用 sum 函数来计算总和,使用 avg 函数来计算平均值,使用 count 函数来计算行数等,还可以结合其他的操作,如过滤、排序等,进一步优化数据处理的流程。
为了提高 GroupBy 操作的性能,还需要注意一些优化技巧,比如合理设置分区数量,避免数据倾斜;使用缓存来减少重复计算;选择合适的存储级别等。
熟练掌握 Spark 的 GroupBy 操作,不仅需要理解其基本原理,还需要在实践中不断积累经验,运用各种优化技巧,以提高数据处理的效率和质量。
参考来源:相关技术文档和实践经验总结。
