深入探究,Hadoop 与 Spark 的显著差异
Hadoop 和 Spark 作为大数据处理领域的重要技术,它们之间存在着诸多差异,这些差异不仅体现在技术架构上,还反映在性能、应用场景等多个方面。
Hadoop 是一个分布式系统基础架构,以其大规模数据存储和处理能力而闻名,它采用了 MapReduce 计算模型,适用于批处理任务,Hadoop 的优势在于其出色的稳定性和可扩展性,能够处理海量的数据,Hadoop 在处理速度上相对较慢,对于实时性要求较高的任务可能表现不佳。
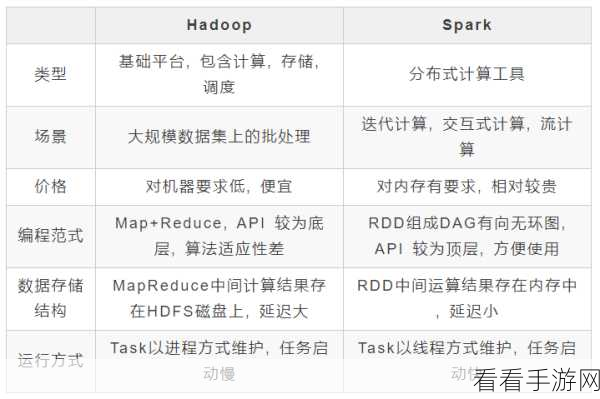
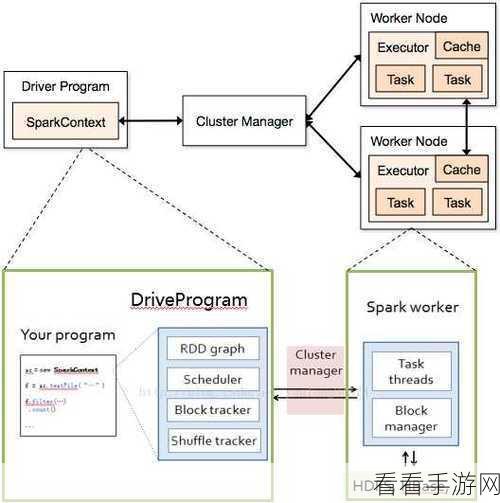
Spark 则是一种快速的通用计算引擎,它在内存计算方面表现出色,Spark 提供了丰富的 API 和高级的编程模型,使得数据处理更加灵活和高效,与 Hadoop 相比,Spark 能够显著提高数据处理的速度,尤其在迭代计算和实时数据处理方面具有明显优势,但 Spark 对资源的需求相对较高,在大规模数据存储方面可能不如 Hadoop 那么强大。
在应用场景方面,Hadoop 常用于大规模数据的存储和离线分析,如数据仓库构建、日志分析等,而 Spark 则更适用于实时数据分析、机器学习、流处理等需要快速响应和迭代计算的场景。
Hadoop 和 Spark 各有其特点和优势,用户在选择使用时应根据具体的业务需求和数据处理要求来进行综合考虑。
参考来源:相关技术文档和专业研究资料。
