深入剖析,Hadoop 与 Spark 性能的巅峰对决
Hadoop 和 Spark 作为大数据处理领域的重要技术,它们的性能一直是人们关注的焦点,在当今数字化时代,数据处理的效率和质量直接影响着企业的竞争力和决策的准确性,深入了解 Hadoop 与 Spark 的性能差异对于开发者和数据工程师来说至关重要。
Hadoop 是一个分布式系统基础架构,具有高度的容错性和可扩展性,它采用了 MapReduce 编程模型,适合处理大规模的离线数据,Hadoop 在处理实时数据和迭代计算方面存在一定的局限性。
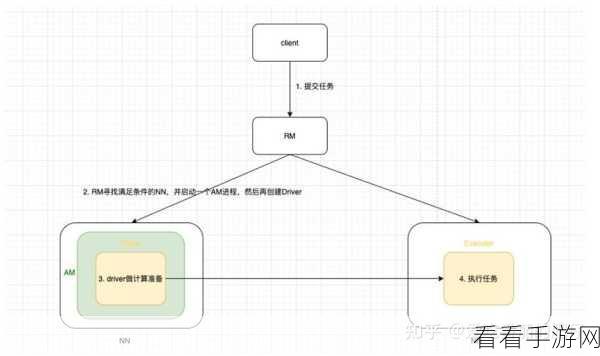
Spark 则是一种快速、通用的大数据计算框架,它基于内存计算,能够显著提高数据处理的速度,尤其在处理迭代计算和实时数据时表现出色,与 Hadoop 相比,Spark 的编程模型更加灵活,支持多种编程语言,并且提供了丰富的高级 API。
在性能对比方面,首先是数据读取速度,Hadoop 在处理大规模数据时,数据读取往往需要较长时间,而 Spark 凭借其内存计算的优势,能够快速读取和处理数据,其次是计算效率,对于复杂的迭代计算任务,Spark 的性能通常优于 Hadoop,能够大大缩短计算时间,资源利用率也是一个重要的考量因素,Hadoop 在资源分配上相对较为保守,而 Spark 能够更有效地利用系统资源,提高计算效率。
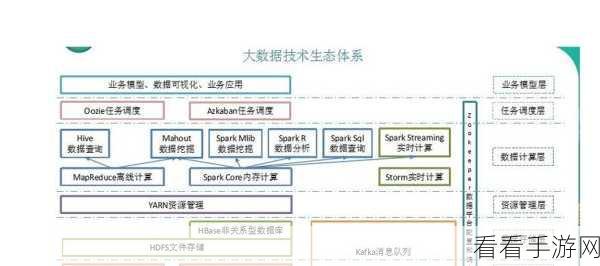
需要注意的是,Hadoop 和 Spark 的性能表现并非绝对,而是受到多种因素的影响,如数据规模、计算任务的类型、硬件配置等,在实际应用中,需要根据具体的业务需求和场景来选择合适的技术。
Hadoop 和 Spark 各有优势和适用场景,了解它们的性能特点,并结合实际业务进行合理选择和优化,将有助于提升大数据处理的效率和质量,为企业创造更大的价值。
文章参考来源:大数据技术相关书籍及权威技术论坛。
