探秘大数据 Spark Hadoop 编程,难度究竟几何?
大数据技术在当今数字化时代扮演着至关重要的角色,而 Spark 和 Hadoop 作为其中的核心框架,其编程难度一直备受关注。
Spark 和 Hadoop 编程之所以具有一定难度,首先在于它们所涉及的技术体系庞大且复杂,这两个框架涵盖了分布式计算、数据存储、数据处理等多个领域的知识,需要开发者具备全面的技术素养。
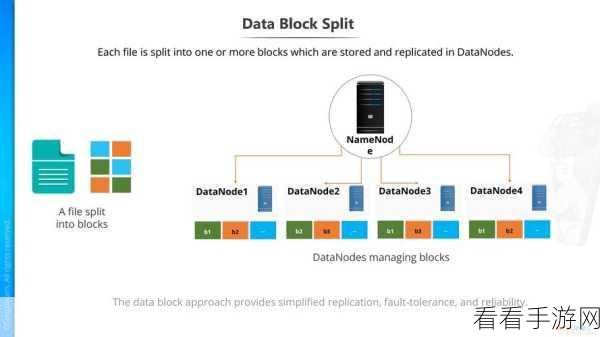
编程环境的搭建和配置也是一项挑战,要让 Spark 和 Hadoop 能够在本地或集群环境中稳定运行,需要处理众多的参数设置和依赖关系,这对于初学者来说可能会感到困惑和棘手。
数据处理的逻辑和算法要求较高,在面对海量数据时,如何设计高效的处理流程、选择合适的算法以及优化性能,都需要开发者具备深厚的编程经验和数据处理能力。
虽然 Spark 和 Hadoop 编程存在难度,但通过系统的学习和实践,也并非不可逾越。
要攻克这一难题,第一步是扎实掌握基础知识,深入理解分布式系统的原理、数据结构和算法等基础概念,为后续的编程工作打下坚实的基础。
第二步是多进行实践操作,通过实际的项目开发,熟悉 Spark 和 Hadoop 的各种功能和接口,积累经验,提高解决问题的能力。
第三步是善于利用社区资源,Spark 和 Hadoop 拥有活跃的开源社区,开发者可以在社区中获取丰富的教程、示例代码和技术交流,从中汲取灵感和解决方案。
虽然大数据 Spark Hadoop 编程具有一定难度,但只要有恒心和正确的学习方法,逐步攻克难关,就能在大数据领域中一展身手。
参考来源:相关技术论坛及专业书籍。
