深度解析,Spark HBase 高效连接的秘诀
Spark 和 HBase 的结合在大数据处理领域中具有重要地位,它们的高效连接为数据处理带来了巨大的优势。
HBase 作为分布式数据库,具有出色的扩展性和实时读写能力,而 Spark 则以其强大的计算能力和高效的并行处理机制著称,两者的强强联合,使得数据处理的效率和性能得到了显著提升。
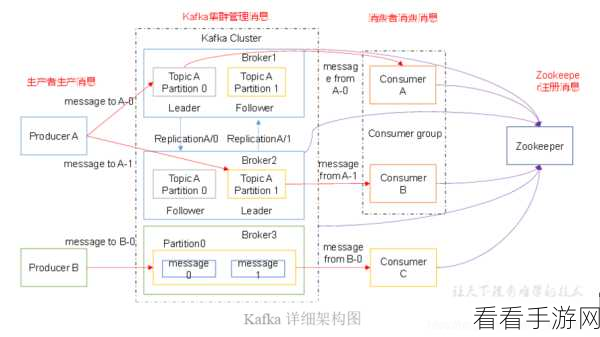
要理解 Spark HBase 为何能高效连接,关键在于它们之间的数据交互方式,Spark 能够通过特定的接口和组件与 HBase 进行无缝对接,实现数据的快速读取和写入,这种交互方式充分利用了两者的优势,避免了数据传输过程中的性能损耗。
配置的优化也是确保高效连接的重要因素,合理调整 Spark 和 HBase 的相关参数,如内存分配、并发度设置等,可以使它们在协同工作时发挥出最佳性能。
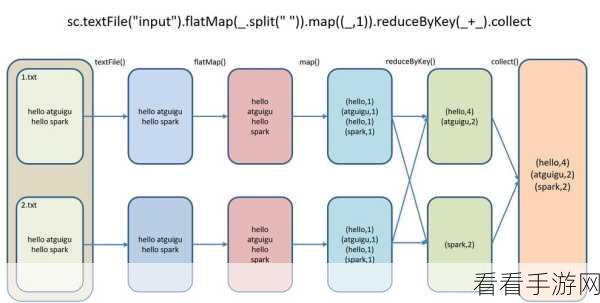
数据结构的设计也对连接效率有着直接影响,在将数据存储于 HBase 时,采用合适的表结构和列族设计,能够提高数据的查询和访问速度,进而提升与 Spark 连接时的整体效率。
Spark HBase 的高效连接并非偶然,而是通过合理的数据交互、优化的配置以及精心设计的数据结构共同实现的,深入研究和掌握这些要点,将有助于我们在大数据处理中充分发挥它们的优势,实现更高效、更准确的数据处理。
文章参考来源:大数据处理相关技术文档和实践经验总结。
