探秘 Spark HBase 数据处理的奇妙之旅
在当今数字化时代,数据处理成为了各个领域的关键环节,而 Spark HBase 数据的处理,更是众多开发者和数据分析师关注的焦点。
HBase 作为一种分布式、面向列的开源数据库,能够存储海量的数据,而 Spark 则以其强大的计算能力和高效的处理速度,为处理大规模数据提供了有力支持。
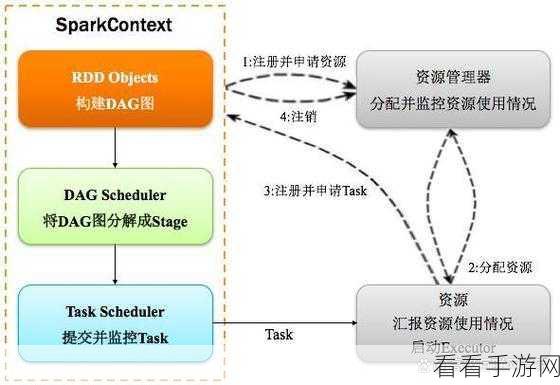
如何有效地处理 Spark HBase 数据呢?
第一步,我们需要明确数据处理的目标和需求,是进行数据分析、数据挖掘,还是构建数据仓库?不同的目标将决定我们采取不同的处理策略。
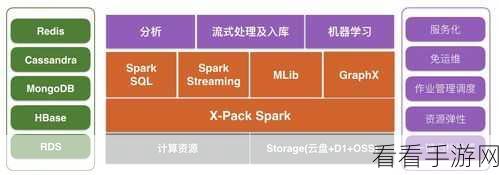
要对数据进行清洗和预处理,这包括去除重复数据、处理缺失值、纠正错误数据等,以确保数据的质量和准确性。
根据数据的特点和处理需求,选择合适的 Spark 操作和算法,对于大规模数据的聚合计算,可以使用 Spark 的 reduceByKey 操作;对于数据的排序和分组,可以使用 sortBy 和 groupBy 等操作。
在数据处理过程中,还需要注意性能优化,合理调整 Spark 的配置参数,如内存分配、并行度等,可以显著提高数据处理的效率。
数据的存储和读取方式也会影响处理效果,要根据数据的访问模式和频率,选择合适的 HBase 表结构和存储方式。
对处理结果进行验证和评估,确保数据处理的结果符合预期,并且能够满足业务需求。
处理 Spark HBase 数据需要综合考虑多个因素,从明确目标到选择合适的方法和策略,再到优化性能和评估结果,每一个环节都至关重要,只有不断探索和实践,才能掌握这一强大的数据处理技术,为业务发展提供有力支持。
参考来源:相关技术文档及行业经验分享。
