掌握 Spark HBase 优化查询的关键秘籍
Spark HBase 在数据处理和查询方面具有强大的功能,但要实现高效的查询,需要掌握一些关键的优化技巧。
优化 Spark HBase 查询的核心在于理解其架构和工作原理,只有深入了解,才能针对性地采取措施提升查询性能。
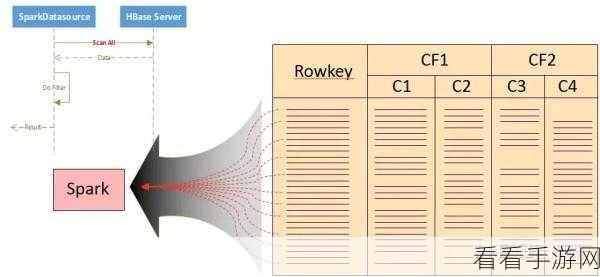
要实现高效查询,数据存储设计至关重要,合理规划表结构、分区策略以及预分区等,能有效减少数据读取量,提高查询效率,根据业务需求确定合适的列族和列数量,避免过度设计导致的性能损耗。
缓存的运用也是优化的重要一环,通过设置合适的缓存策略,将经常访问的数据缓存在内存中,可以大大减少数据读取的时间开销,注意缓存的更新机制,确保数据的准确性和时效性。
索引的建立能显著加快查询速度,但要谨慎选择索引字段,避免过度索引带来的维护成本增加和写入性能下降。
优化查询语句同样不可忽视,避免复杂的连接操作和不必要的全表扫描,合理利用条件过滤和分页等功能,能够有效提升查询的执行效率。
优化 Spark HBase 查询是一个综合性的工作,需要从多个方面入手,结合实际业务需求和数据特点,不断尝试和调整,才能达到理想的效果。
文章参考来源:相关技术论坛及专业书籍。
