探索 Spark HBase 的卓越之处
Spark HBase 作为大数据处理领域的重要技术组合,具有诸多令人瞩目的优势特点,它在数据存储和处理方面展现出了强大的能力,为企业和开发者带来了高效、灵活且可靠的解决方案。
Spark 是一个快速、通用的大数据计算框架,而 HBase 则是一种分布式的、面向列的开源数据库,当它们结合在一起时,产生了强大的协同效应。
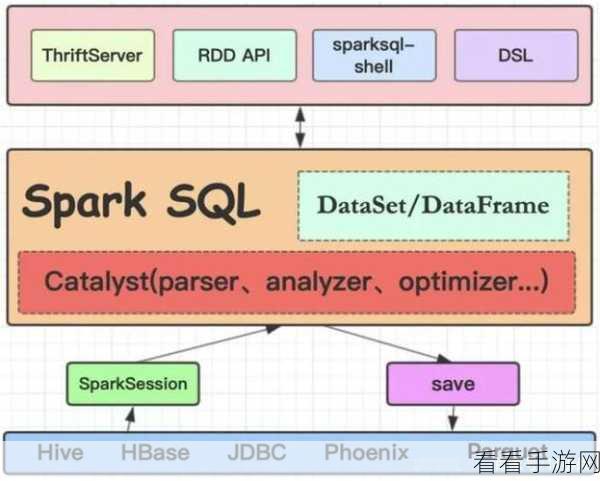
Spark HBase 能够实现高效的数据读取和写入,HBase 本身具有出色的随机读写性能,而 Spark 则通过其优化的计算引擎,能够快速地处理大规模的数据读写请求,大大提高了数据处理的效率。
其具备强大的扩展性,无论是数据量的增长还是处理需求的增加,Spark HBase 都能够轻松应对,可以方便地添加新的节点来扩展存储和计算能力,以适应不断变化的业务需求。
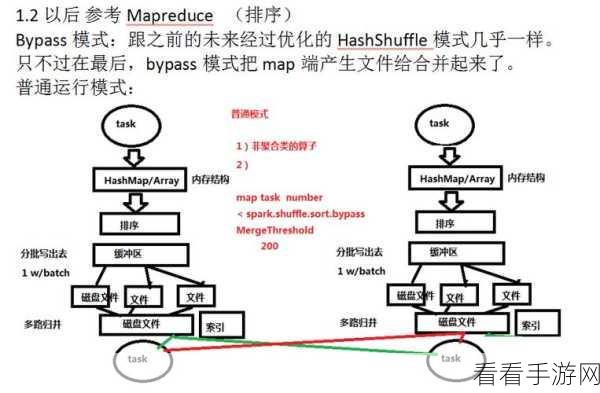
Spark HBase 支持复杂的数据分析和处理操作,借助 Spark 丰富的数据分析库和算法,能够对存储在 HBase 中的数据进行深度挖掘和分析,为决策提供有力支持。
在数据一致性方面,Spark HBase 也表现出色,它确保了数据在处理和存储过程中的准确性和完整性,降低了数据错误和不一致的风险。
Spark HBase 的优势特点使其成为大数据处理领域的有力工具,为企业的数字化转型和业务创新提供了坚实的技术支撑。
参考来源:大数据技术相关权威资料及行业研究报告。
仅供参考,您可以根据实际需求进行调整和修改。
