深入探索 Spark HBase 数据存储的神秘原理
在当今数字化时代,数据存储成为了至关重要的环节,Spark 和 HBase 作为强大的数据处理和存储工具,其数据存储原理备受关注。
Spark HBase 数据存储原理具有独特的特点和优势,HBase 是一个分布式、面向列的开源数据库,它基于 Hadoop 生态系统,能够提供高可靠性、高性能的数据存储和检索服务,而 Spark 则是一个快速、通用的大数据处理框架,擅长处理大规模数据的计算和分析。
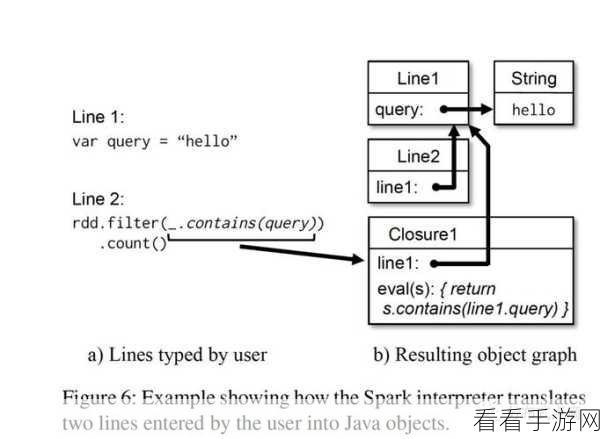
Spark 与 HBase 的结合,为数据存储带来了全新的可能性,在数据存储过程中,Spark 可以利用其强大的计算能力对数据进行预处理和转换,然后将处理后的数据存储到 HBase 中,HBase 则通过其分布式架构和列存储的方式,有效地存储和管理海量数据。
要深入理解 Spark HBase 数据存储原理,需要了解其关键技术和机制,HBase 的数据模型和存储结构,包括行键、列族、列限定符等概念,Spark 的数据处理流程和与 HBase 的交互方式也是重要的知识点。
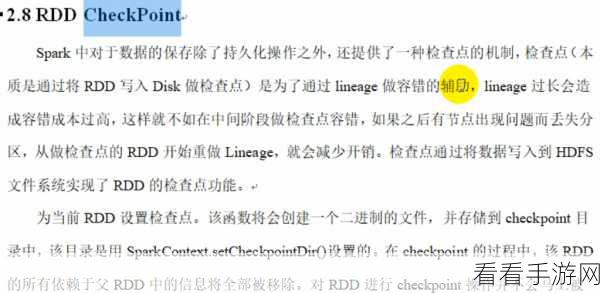
为了更好地应用 Spark HBase 进行数据存储,还需要掌握一些优化技巧,合理设计数据的分区和索引,调整参数以提高性能,以及处理数据的一致性和容错性等方面。
深入研究 Spark HBase 数据存储原理,对于提升大数据处理和存储的效率和质量具有重要意义,通过不断学习和实践,我们能够充分发挥这两个工具的优势,为各种应用场景提供可靠的数据支持。
参考来源:相关技术文档和权威研究资料。
