深入探究,Spark、HBase 与 Hive 的显著差异
在当今大数据处理领域,Spark、HBase 和 Hive 都是备受关注的技术,它们在数据存储、处理和查询方面有着各自的特点和优势,让我们一起深入了解它们之间的区别。
Spark 是一种快速、通用的大数据处理框架,它具有出色的内存计算能力,能够高效地处理大规模数据,Spark 支持多种编程语言,如 Java、Python 和 Scala,这使得开发者可以根据自己的喜好和项目需求选择合适的语言进行开发。
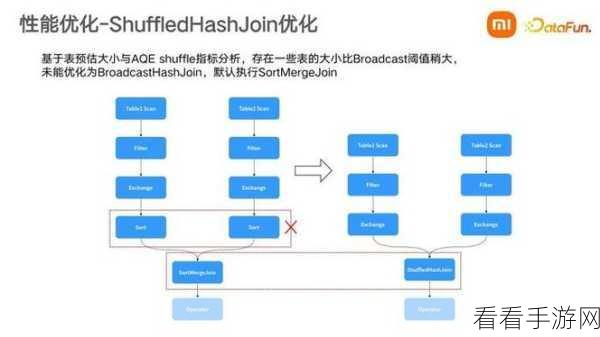
HBase 则是一个面向列的分布式数据库,它适用于需要实时读写、随机访问的大规模数据应用场景,HBase 基于 Hadoop 分布式文件系统(HDFS)构建,具有高可靠性和可扩展性。
Hive 是基于 Hadoop 的数据仓库工具,它提供了类似 SQL 的查询语言,使得熟悉传统关系型数据库的用户能够更轻松地处理和分析大规模数据,Hive 适用于数据仓库和离线数据分析任务。
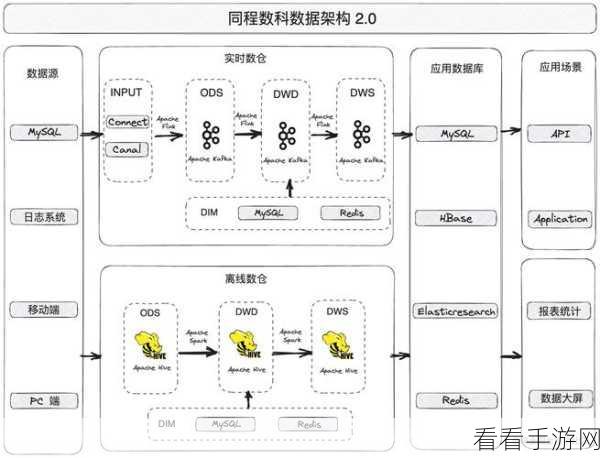
从数据存储结构来看,Spark 本身并不负责数据存储,而是专注于数据处理和计算,HBase 采用列式存储,能够快速检索和更新特定列的数据,Hive 通常将数据存储在 HDFS 中,以表的形式组织数据。
在数据处理能力方面,Spark 具有强大的实时处理和批处理能力,能够应对复杂的计算任务,HBase 主要用于实时数据的读写操作,对于复杂的分析计算支持相对较弱,Hive 则更擅长离线数据的批量处理和分析。
在应用场景上,Spark 广泛应用于数据挖掘、机器学习、实时流处理等领域,HBase 常用于实时数据存储和查询,如互联网应用中的用户行为数据,Hive 则在构建数据仓库、进行大规模数据的统计分析等方面发挥重要作用。
Spark、HBase 和 Hive 各有千秋,在实际应用中,应根据具体的业务需求和数据特点选择合适的技术,以达到最佳的数据处理效果。
文章参考来源:大数据技术相关书籍及网络资料。
