轻松搞定 C UnicodeEncoding 编码兼容性难题
在软件开发中,C#的 UnicodeEncoding 编码兼容性处理是一个让不少开发者头疼的问题,但别担心,本文将为您详细剖析并提供有效的解决之道。
C#中的 UnicodeEncoding 编码在处理数据时扮演着重要角色,如果处理不当,可能会导致数据丢失、显示异常等一系列问题。
要解决编码兼容性问题,我们需要深入理解 UnicodeEncoding 的工作原理,它采用了特定的编码规则来表示字符,而不同的编码方式之间可能存在差异。
我们探讨一些实用的处理方法,在进行数据读写操作时,要明确指定正确的编码方式,以避免出现乱码,对于不同来源的数据,要进行有效的编码转换,确保数据的一致性和准确性。
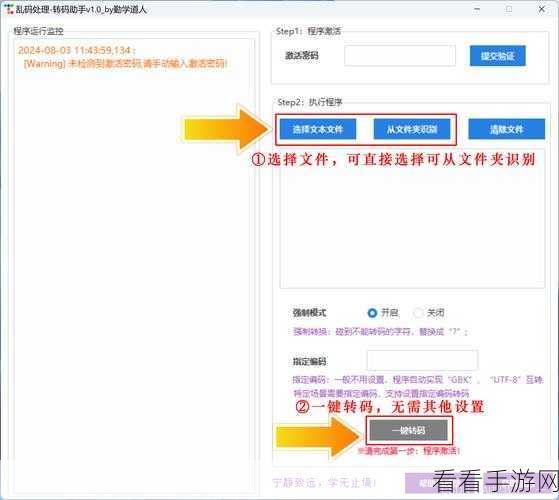
还需要注意字符集的选择,常见的字符集如 UTF-8、UTF-16 等,各自有着不同的特点和适用场景,根据实际需求合理选择字符集,能大大提高编码兼容性。
在实际开发中,不断测试和验证编码处理的效果也是至关重要的,通过对各种情况的模拟和检验,及时发现并解决潜在的问题。
只要我们掌握了正确的方法和技巧,C# UnicodeEncoding 的编码兼容性问题就不再是难以逾越的障碍,相信通过本文的介绍,您在处理相关问题时会更加得心应手。
参考来源:个人多年编程经验总结。