Stream Kafka 数据并行处理秘籍大公开
在当今数字化时代,数据处理成为了众多领域的关键任务,而 Stream Kafka 作为一款强大的数据处理工具,其数据并行处理能力备受关注。
Stream Kafka 能够实现高效的数据并行处理,有着诸多优势,它可以快速处理大规模的数据,提升数据处理的效率和速度,其灵活的配置和扩展性,能够满足不同场景下的需求。
Stream Kafka 是如何进行数据并行处理的呢?这主要依靠其独特的架构和设计,它采用了分布式的处理方式,将数据分发到多个节点上进行并行处理,从而大大提高了处理速度,Stream Kafka 运用了分区机制,将数据划分成不同的分区,每个分区可以独立地进行处理,进一步提升了并行处理的能力,它还具备良好的容错机制,当某个节点出现故障时,能够自动将任务分配到其他正常的节点上,确保数据处理的连续性和稳定性。
在实际应用中,为了充分发挥 Stream Kafka 数据并行处理的优势,还需要注意一些要点,合理设置分区数量和副本数量,根据数据量和处理需求进行优化,要关注系统的资源使用情况,避免出现资源不足导致的性能下降。
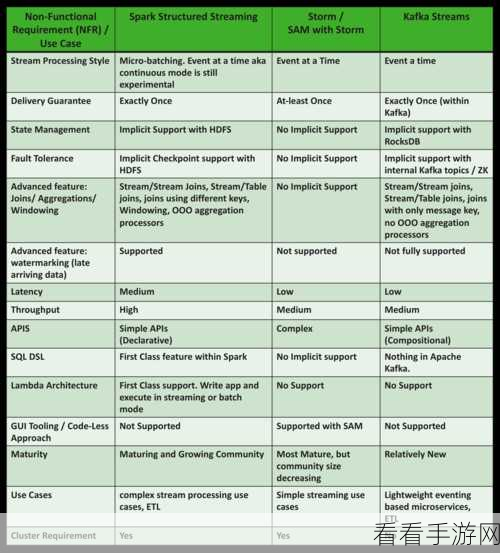
Stream Kafka 的数据并行处理功能为我们处理海量数据提供了强大的支持,只要掌握了正确的方法和技巧,就能充分发挥其优势,提升数据处理的效率和质量。
文章参考来源:相关技术文档及行业研究报告。