Stream Kafka 高并发处理秘籍大公开
在当今数字化时代,数据处理的需求日益增长,特别是在高并发场景下,如何有效地处理数据成为了关键问题,Stream Kafka 作为一款强大的消息队列系统,其在应对高并发方面有着独特的策略和方法,就让我们一起深入探索 Stream Kafka 处理高并发的奥秘。
中心句:Stream Kafka 作为一款强大的消息队列系统,在高并发场景下的处理方式至关重要。
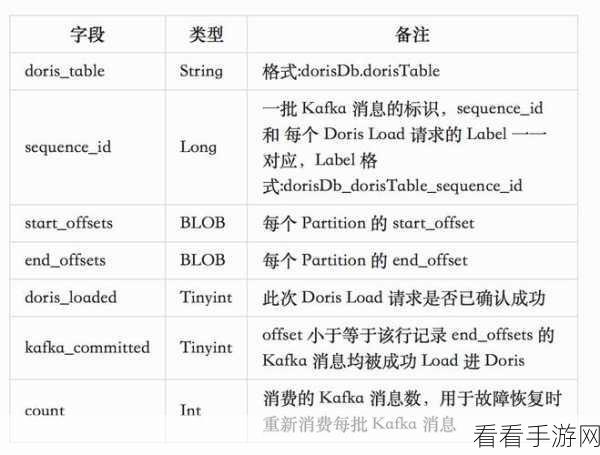
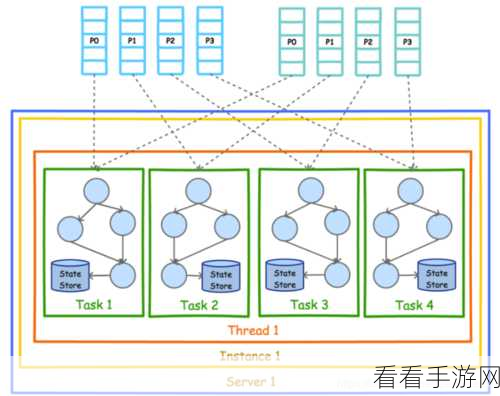
Stream Kafka 处理高并发的关键在于其优秀的分区机制,通过合理地划分分区,可以将数据均匀分布到不同的节点上,从而实现并行处理,提高系统的吞吐量,分区的数量和分配策略需要根据实际的业务需求和数据特点进行精心设计,对于数据量较大且分布较为均匀的场景,可以采用哈希分区;而对于具有特定业务逻辑的数据,可以采用自定义的分区策略,以确保数据能够被正确地路由到相应的处理节点。
中心句:Stream Kafka 处理高并发的关键在于优秀的分区机制,需根据实际情况设计分区策略。
缓存机制也是 Stream Kafka 应对高并发的重要手段之一,通过在内存中设置缓存,可以有效地减少磁盘 I/O 操作,提高数据的读写效率,缓存的大小和淘汰策略需要根据系统的资源和数据访问模式进行优化调整,在内存资源充足的情况下,可以适当增大缓存的大小,以提高缓存命中率;而对于数据更新频繁的场景,则需要采用更灵活的缓存淘汰策略,以保证数据的新鲜度和准确性。
中心句:缓存机制是 Stream Kafka 应对高并发的重要手段,其设置需根据系统资源和数据访问模式优化。
Stream Kafka 还支持数据压缩,这在高并发环境下能够显著减少网络传输的数据量,提高传输效率,常见的数据压缩算法如 Gzip、Snappy 等,可以根据数据的特点和性能要求进行选择,数据的序列化和反序列化方式也会影响系统的性能,选择高效的序列化框架如 Avro、Protobuf 等,可以进一步提升数据处理的效率。
中心句:数据压缩和高效的序列化方式能提升 Stream Kafka 在高并发环境下的性能。
在实际应用中,还需要对 Stream Kafka 的配置参数进行精细的调整和优化,调整 Broker 的内存分配、消息的保留时间、副本数量等参数,都可以对系统的性能和稳定性产生重要影响,结合监控工具对系统的运行状态进行实时监测和分析,及时发现并解决潜在的性能瓶颈问题,也是保障系统在高并发场景下稳定运行的关键。
中心句:实际应用中要精细调整 Stream Kafka 的配置参数,并结合监控保障系统稳定运行。
Stream Kafka 处理高并发并非一蹴而就,需要综合考虑分区机制、缓存策略、数据压缩、配置优化以及监控等多个方面,只有深入理解并合理运用这些技术手段,才能充分发挥 Stream Kafka 的优势,构建高效稳定的数据处理系统。
文章参考来源:相关技术文档及行业实践经验。
仅供参考,您可以根据实际需求进行修改调整。