探秘 Flink 与 Kafka 数据格式转换的奇妙之旅
Flink 和 Kafka 作为大数据处理领域的重要工具,它们之间的数据格式转换一直是开发者们关注的焦点,在实际应用中,实现高效且准确的数据格式转换对于提升系统性能和数据处理效率至关重要。
Flink 具有强大的流处理能力,能够实时处理大量的数据,而 Kafka 则是优秀的分布式消息队列,常用于数据的传输和存储,当这两者结合时,数据格式的转换就成为了一个关键环节。
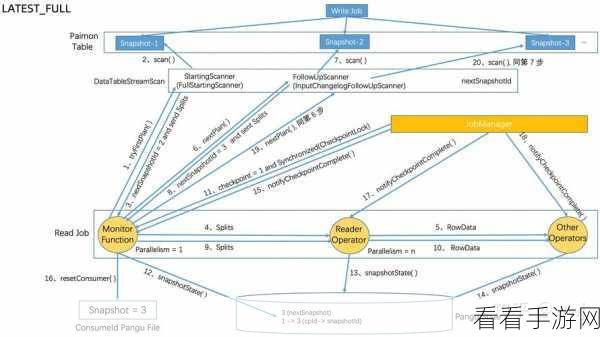
要实现 Flink 和 Kafka 之间的数据格式转换,首先需要了解它们各自支持的数据格式,Flink 支持多种常见的数据格式,如 JSON、Avro 等,Kafka 也同样支持多种格式,如二进制、字符串等。
在进行数据格式转换时,需要根据具体的业务需求和数据特点选择合适的转换方式,一种常见的方法是使用 Flink 的内置函数和转换操作来处理数据格式的转换,可以使用 Flink 的 MapFunction 对数据进行字段的提取、转换和重组。
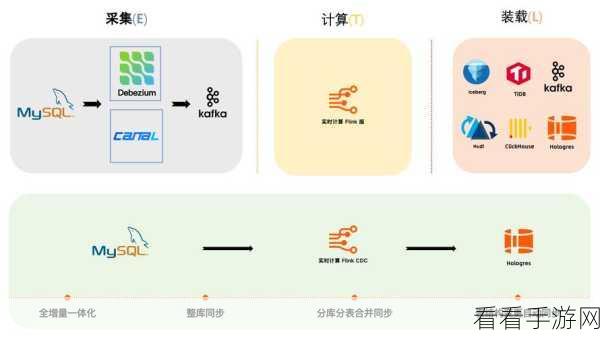
还可以利用 Flink 的DeserializationSchema 和 SerializationSchema 来定义数据的解析和序列化规则,从而实现与 Kafka 数据格式的适配。
在配置 Flink 和 Kafka 的连接参数时,也需要注意数据格式的相关设置,确保数据能够正确地在两者之间传输和转换。
掌握 Flink 和 Kafka 之间的数据格式转换技巧,对于优化大数据处理流程、提高系统性能具有重要意义,不断探索和实践,才能在实际应用中实现更加高效和精准的数据处理。
文章参考来源:大数据处理相关技术文档和实践经验。